Kafka vs RabbitMQ: scegliere il message broker giusto
Quando parliamo di sistemi distribuiti, alta concorrenza, applicazioni che devono scalare a un volume elevato di richieste al secondo e operazioni asincrone, entrano in gioco le code di messaggi. Da lì esistono diverse tecnologie con i loro pro e contro, e le principali sono Kafka e RabbitMQ. In questo articolo esploriamo entrambe, con alcuni casi d’uso che ci aiuteranno a capire quando è “meglio” usare l’una o l’altra.
Capire Kafka: un sistema di streaming distribuito
Apache Kafka è una piattaforma open source di streaming di eventi distribuita, nota per l’alto throughput, la tolleranza ai guasti e l’elaborazione dei dati in tempo reale. Kafka segue un modello publish-subscribe in cui i producer scrivono messaggi nei topic e i consumer si iscrivono a quei topic per riceverli. Kafka conserva i messaggi in un distributed commit log, che gli garantisce alta scalabilità e tolleranza ai guasti. Questo permette un throughput elevato e la riproduzione dei messaggi, rendendolo ideale per l’elaborazione dei dati in tempo reale e l’event sourcing.
L’architettura di Kafka ha tre componenti principali: producer, broker e consumer. I producer pubblicano messaggi nei topic di Kafka e i broker si occupano di conservare e replicare i dati nel cluster Kafka. I consumer leggono i dati da uno o più topic, il che permette l’elaborazione in parallelo e la scalabilità.
RabbitMQ: un message broker flessibile e affidabile
RabbitMQ è un message broker open source e flessibile che implementa il protocollo AMQP. Segue un modello tradizionale di message queue, che permette alle applicazioni di comunicare in modo asincrono inviando e ricevendo messaggi, con la consegna in ordine a consumer specifici. Questo garantisce un ordinamento affidabile dei messaggi e flessibilità nel message routing, rendendolo adatto all’elaborazione di task e alla comunicazione tra microservizi.
L’architettura di RabbitMQ ruota attorno a un message broker centrale, che fa da intermediario tra producer e consumer. Per la replica e la conservazione dei messaggi, i producer inviano i messaggi agli exchange, e gli exchange li instradano verso le queue in base a regole predefinite. I consumer poi prelevano i messaggi dalle code e li elaborano.
Differenze fondamentali: architettura e modello di consumo
Da una parte c’è il Broker, l’intermediario: l’infrastruttura e il funzionamento interno di ciascuna di queste tecnologie. Dall’altra c’è il Consumer, cioè come consumiamo da quel Broker, e qui le cose cambiano molto.
RabbitMQ
-
In RabbitMQ il
Brokerè considerato unoSmart Brokerperché svolge molto lavoro, come l’instradamento dei messaggi, la persistenza e la consegna ai consumer giusti. -
Il
Brokerusa gliExchangeper ricevere i messaggi dai producer. Ogni messaggio contiene unaRouting Key, che l’Exchangeesamina per decidere a qualiQueueinviarlo, in base alle regole diBindingstabilite. -
Un
Bindingè una relazione tra unExchangee unaQueue, e definisce quali messaggi devono essere instradati verso unaQueuespecifica. La relazione si stabilisce tramite unaBinding Key. -
RabbitMQ supporta diversi tipi di
Exchange, comeDirect,Fanout,TopiceHeaders, ciascuno con il proprio algoritmo per confrontare laRouting Keydel messaggio con leBinding Keye decidere l’instradamento. -
Una caratteristica potente di RabbitMQ è il
Multiplexingdei messaggi: un singolo messaggio può essere consegnato a piùQueuese le loroBinding Keycorrispondono allaRouting Keydel messaggio. Così piùConsumerpossono gestire lo stesso messaggio per scopi diversi. -
Al contrario dello
Smart Broker, iConsumerin RabbitMQ sono consideratiDumb Consumer, perché la loro unica responsabilità è consumare i messaggi dalleQueuea cui sono iscritti. Di default RabbitMQ distribuisce i messaggi aiConsumerin modo equo con un algoritmoRound-Robin. -
Questo design
Smart BrokereDumb Consumerdà un sistema di messaggistica molto flessibile e scalabile, in cui i componenti possono essere modificati o sostituiti in modo indipendente, purché rispettino le convenzioni di messaggistica stabilite.
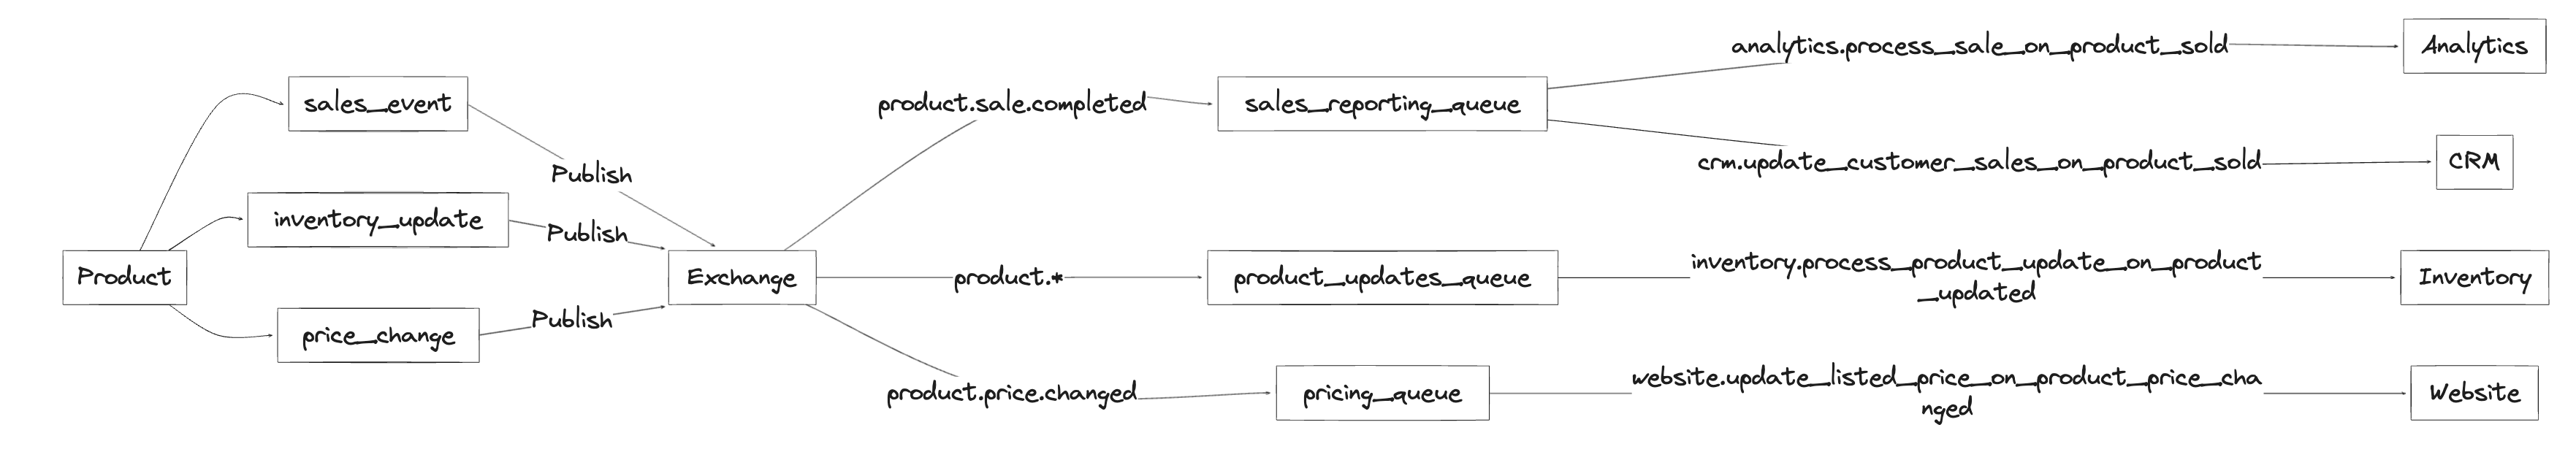
In questo diagramma vediamo un esempio del flusso dei messaggi in RabbitMQ. Il Producer invia diversi eventi (sales_event, inventory_update, price_change) all’Exchange. L’Exchange instrada questi messaggi verso le Queue appropriate in base alle Routing Key e ai Binding.
I messaggi vengono poi consumati da diversi Consumer per svolgere vari compiti, come aggiornare il database delle vendite (CRM), elaborare gli aggiornamenti di magazzino (Inventory), aggiornare i prezzi sul sito (Website) e generare report di vendita (Analytics).
Questo esempio mostra come RabbitMQ faciliti una comunicazione disaccoppiata tra i diversi componenti di un sistema, permettendo un’elaborazione asincrona e scalabile di eventi e task.
Kafka
-
In Kafka i messaggi non vanno a un
Brokercentrale, ma vengono conservati neiTopicin unLogdistribuito. Kafka segue un modelloPublish-Subscribe, in cui iProducerpubblicano messaggi neiTopice iConsumersi iscrivono a queiTopicper riceverli. -
Un
Topicin Kafka è una categoria o un feed con un nome, in cui vengono pubblicati i record. ITopicin Kafka sono sempre multi-producer e multi-consumer: unTopicpuò avere zero, uno o moltiProducerche vi scrivono e zero, uno o moltiConsumerche lo leggono. -
Per ogni
Topic, il cluster Kafka mantiene unLogpartizionato. Ogni partizione è una sequenza ordinata e immutabile di record, aggiunti continuamente a un commit log strutturato. A ogni record della partizione viene assegnato un numero identificativo sequenziale chiamatoOffset, che lo identifica in modo univoco all’interno della partizione. -
Kafka è un sistema distribuito, quindi un
Topicdi solito ha diverse partizioni distribuite su più server del cluster Kafka. Questo permette di scalare oltre la capacità di un singolo server. -
I
Consumersi etichettano con il nome di unConsumer Group, e ogni record pubblicato in unTopicviene consegnato a un’istanza consumer all’interno di ciascunConsumer Groupiscritto. LeConsumer Instancepossono trovarsi in processi o macchine separati. -
Se tutte le istanze
Consumerhanno lo stessoConsumer Group, i record vengono di fatto bilanciati tra di esse. Se tutte le istanzeConsumerhannoConsumer Groupdiversi, ogni record viene trasmesso a tutti i processiConsumer.
-
Il
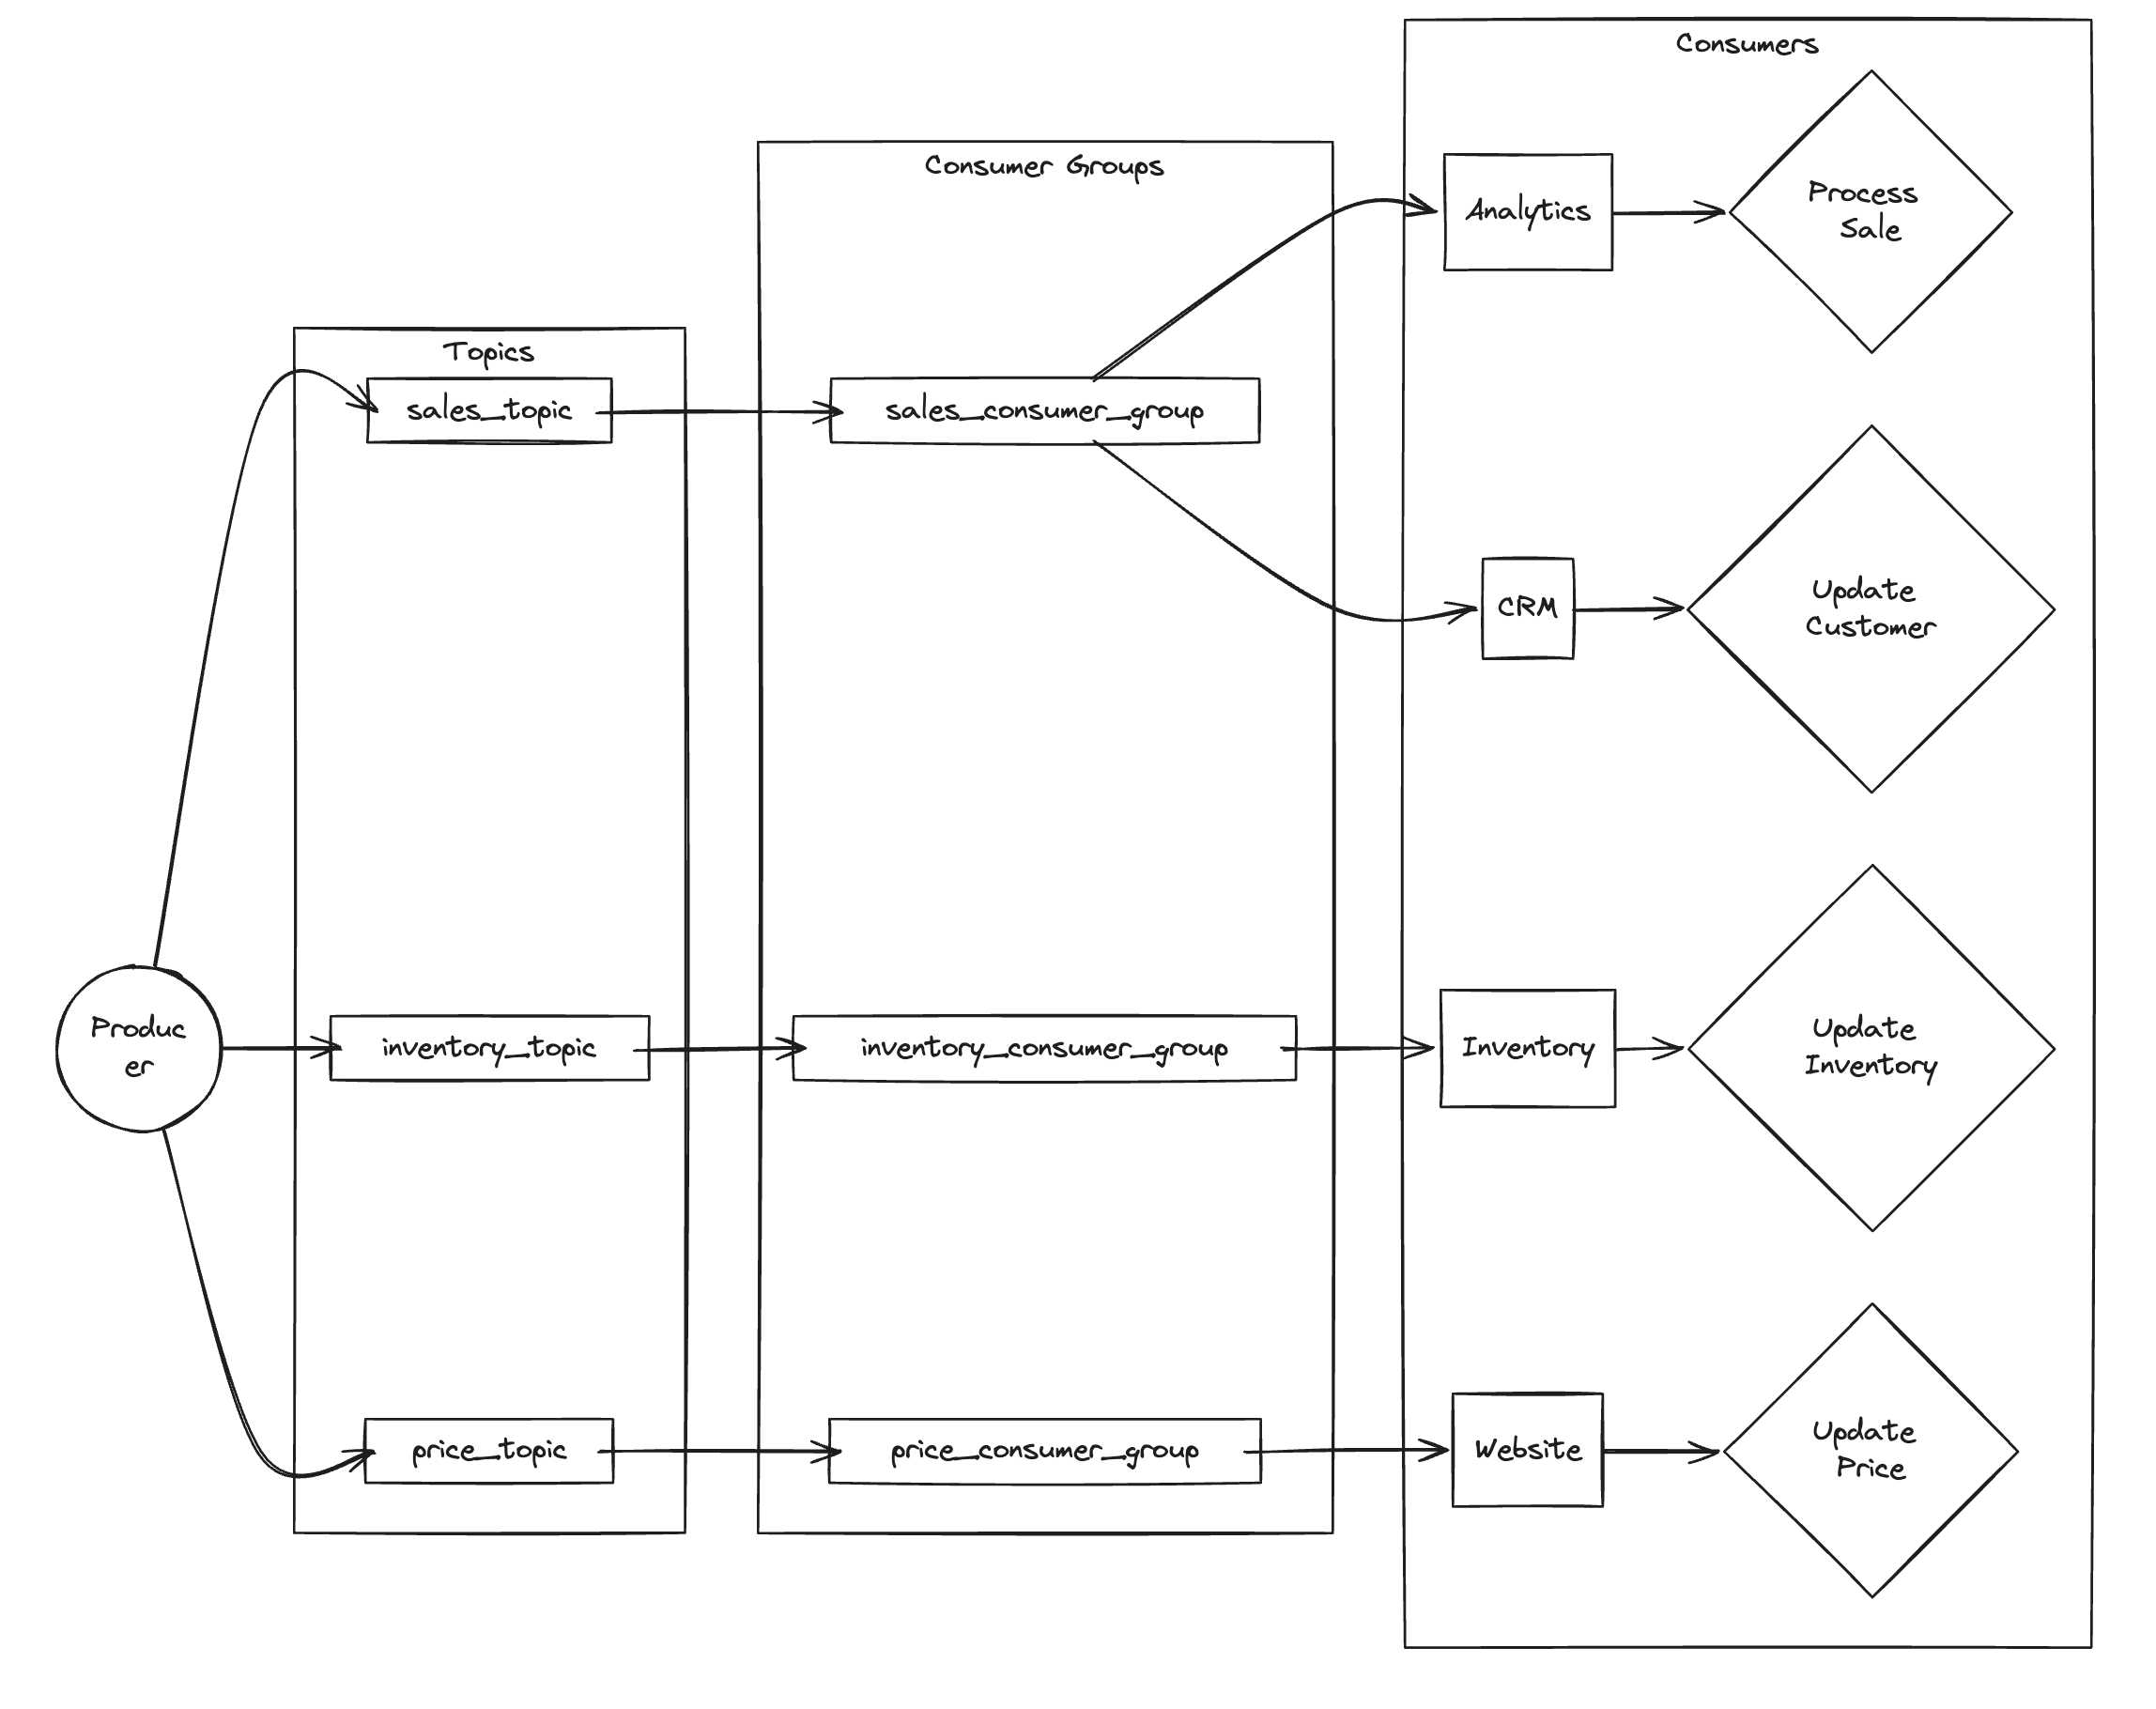
Producerpubblica messaggi in treTopic:sales_topic,inventory_topiceprice_topic. -
Ogni
Topicha il proprioConsumer Group:sales_consumer_group,inventory_consumer_groupeprice_consumer_group. IConsumer Groupsi iscrivono aiTopicper consumare i messaggi. -
All’interno di ogni
Consumer Groupci sono singoliConsumerche svolgono azioni specifiche:Analyticselabora le vendite.CRMaggiorna le informazioni sul cliente.Inventoryaggiorna ilmagazzino.Websiteaggiorna i prezzi.
-
I
TopicinKafkasonopartizionatiereplicatiper lascalabilitàe latolleranza ai guasti. Ognipartizioneè unlogordinato e immutabile di messaggi. -
I
Consumermantengono il propriooffset(posizione) in ognipartizioneche consumano, così ognuno può consumare in modo indipendente e al proprio ritmo.
Prestazioni e scalabilità: Kafka vs RabbitMQ
Quanto alle prestazioni, Kafka e RabbitMQ offrono funzionalità simili ma hanno punti di forza diversi.
Kafka
Eccelle negli scenari di streaming di dati in tempo reale e ad alto throughput, con un’ottima scalabilità e una bassa latenza. Può gestire milioni di messaggi al secondo, il che lo rende adatto ai casi d’uso che richiedono un’elaborazione dei dati rapida e continua. La sua architettura scala orizzontalmente distribuendo il carico su più broker, gestendo grandi volumi di dati in modo efficiente. Offre inoltre solide garanzie di durabilità salvando i messaggi su disco, assicurando tolleranza ai guasti e durabilità dei dati.
RabbitMQ
Offre una consegna affidabile dei messaggi grazie a funzioni come gli acknowledgement e la persistenza dei messaggi. Può gestire migliaia di messaggi al secondo, il che lo rende adatto a casi d’uso con requisiti di throughput moderati. La sua architettura centralizzata può introdurre un certo overhead, ma offre robustezza e integrità dei messaggi. Scala verticalmente, ma la scalabilità orizzontale è limitata rispetto a Kafka.
Casi d’uso ideali per Kafka e RabbitMQ
Kafka
Ideale per un’ampia varietà di casi d’uso:
- Analisi in tempo reale e applicazioni di
streaming Event sourcing, ingestione elog aggregation, soprattutto con ibig data.Data pipelinee comunicazione tra microservizi con elaborazione di messaggi ad alto volume- Applicazioni che richiedono alta scalabilità e tolleranza ai guasti
RabbitMQ
Adatto per:
Task processing, integrazione di servizi,workflow orchestratione gestione dei flussi di lavoro, incluse metriche e notifiche.- Comunicazione asincrona tra microservizi
- Sistemi di messaggistica aziendale con consegna affidabile dei messaggi, comprese priorità dei messaggi ed esigenze di instradamento complesse.
La flessibilità di RabbitMQ nel supportare pattern di messaggistica come point-to-point, publish-subscribe e request-response lo rende utile in molti scenari applicativi.
Una guida per scegliere bene
In definitiva, la scelta migliore dipende dalle tue esigenze specifiche:
- Dai priorità all’alto throughput e all’elaborazione dei dati in tempo reale? Usa Kafka.
- Hai bisogno di una consegna affidabile dei messaggi e di un instradamento flessibile per carichi moderati? Usa RabbitMQ.
- Stai valutando il
message replaye lalog aggregation? Kafka è il candidato forte. - Cerchi una scalabilità senza intoppi per la comunicazione tra microservizi ad alto volume? Kafka la supporta.
Ricorda: nessuno dei due è intrinsecamente “migliore”. Analizzare i tuoi requisiti specifici e considerare fattori come ridondanza, scalabilità, alto throughput, alta disponibilità, un’API su larga scala e sicurezza è fondamentale per prendere una decisione informata.
Altri aspetti da considerare
- Complessità: l’architettura distribuita e il log
append-onlydi Kafka possono richiedere più esperienza operativa rispetto all’approccio più semplice basato su code di RabbitMQ. - Comunità e supporto: entrambe le piattaforme hanno comunità ampie e uno sviluppo attivo.
- Integrazione: valuta le integrazioni disponibili con la tua infrastruttura e i tuoi strumenti esistenti.
Scegliere la strada giusta per la tua architettura basata sugli eventi
Con una comprensione chiara delle differenze architetturali, dei benchmark di prestazioni e dei casi d’uso ideali, puoi scegliere tra Kafka e RabbitMQ con sicurezza. Quindi immergiti nelle esigenze specifiche del tuo progetto e parti verso un’architettura basata sugli eventi robusta ed efficiente.