Kafka vs RabbitMQ: Seleccionando el Message Broker Adecuado
Cuando hablamos de sistemas distribuidos y alta concurrencia y aplicaciones que tienen que escalar a un volumen elevado de peticiones por segundo, operaciones asíncronas aparece un elemento que tiene que ver con las colas de mensajería, a partir de ahí hay varias tecnologías con sus pros y sus contras, las principales son Kafka y RabbitMQ. En este articulo de blog, vamos a explorar ambas tecnologías, algunos casos de uso que nos ayudaran a determinar cuando es “mejor” utilizar una tecnología u otra.
Comprendiendo Kafka: Un Sistema de Streaming Distribuido
Apache Kafka es una plataforma de transmisión de eventos distribuida de código abierto conocida por sus capacidades de alto rendimiento, tolerancia a fallos y procesamiento de datos en tiempo real. Kafka sigue un modelo de publicación-suscripción donde los productores escriben mensajes en topics, y los consumidores se suscriben a esos topics para recibir los mensajes. Kafka almacena los mensajes en un distributed commit log, permitiendo una alta escalabilidad y tolerancia a fallos. Esto permite un alto rendimiento y capacidades de reproducción de mensajes, haciéndolo ideal para el procesamiento de datos en tiempo real y el event sourcing.
La arquitectura de Kafka consta de tres componentes principales: producers, brokers y consumers. Los producers publican mensajes en los topics de Kafka, y los brokers son responsables de almacenar y replicar los datos en el clúster de Kafka. Los consumers leen datos de uno o más topics, permitiendo el procesamiento paralelo y la escalabilidad.
RabbitMQ: Un Message Broker Flexible y Confiable
RabbitMQ es un message broker flexible y de código abierto que implementa el protocolo AMQP. Sigue un modelo tradicional de message queue, permitiendo que las aplicaciones se comuniquen de forma asíncrona mediante el envío y la recepción de mensajes y la entrega de mensajes en orden a consumidores específicos. Esto garantiza un orden de mensajes confiable y flexibilidad en el message routing, haciéndolo adecuado para el procesamiento de tareas y la comunicación de microservicios.
La arquitectura de RabbitMQ se centra en un message broker central, que actúa como intermediario entre productores y consumidores. Para la replicación y retención de mensajes, los productores envían mensajes a los exchanges, y esos exchanges enrutan los mensajes a las queues basándose en reglas predefinidas. Los consumidores luego recuperan los mensajes de las colas y los procesan.
Diferencias Fundamentales: Arquitectura y Modelo de Consumo
Está el sistema del Broker que es el intermediario, es la infraestructura y como funciona por dentro cada una de las tecnologías ya mencionadas. Por otro lado esta la parte del Consumerque indica como consumimos de este Broker que cambia mucho.
RabbitMQ
-
En RabbitMQ, el
Brokerse considera unSmart Brokerporque realiza una gran cantidad de trabajo, como el enrutamiento de mensajes, la persistencia y la entrega de mensajes a los consumidores apropiados. -
El
BrokerutilizaExchangespara recibir mensajes de los productores. Cada mensaje contiene unaRouting Key, que elExchangeexamina para determinar a quéQueuesdebe enviar el mensaje basándose en las reglas deBindingsestablecidas. -
Un
Bindinges una relación entre unExchangey unaQueue, y define qué mensajes deben enrutarse a unaQueueespecífica. Esta relación se establece mediante unaBinding Key. -
RabbitMQ soporta diferentes tipos de
Exchanges, comoDirect,Fanout,TopicyHeaders, cada uno con su propio algoritmo para comparar laRouting Keydel mensaje con lasBinding Keyspara decidir el enrutamiento. -
Una característica potente de RabbitMQ es la
Multiplexaciónde mensajes, donde un solo mensaje puede entregarse a múltiplesQueuessi susBinding Keyscoinciden con laRouting Keydel mensaje. Esto permite que múltiplesConsumersmanejen el mismo mensaje para diferentes propósitos. -
En contraste con el
Smart Broker, losConsumersen RabbitMQ son consideradosDumb Consumersporque su única responsabilidad es consumir mensajes de lasQueuesa las que están suscritos. RabbitMQ entrega los mensajes a losConsumersde manera equitativa mediante un algoritmo deRound-Robinpor defecto. -
Este diseño de
Smart BrokeryDumb Consumerpermite un sistema de mensajería altamente flexible y escalable, donde los componentes pueden ser modificados o reemplazados independientemente, siempre que adhieran a las convenciones de mensajería establecidas.
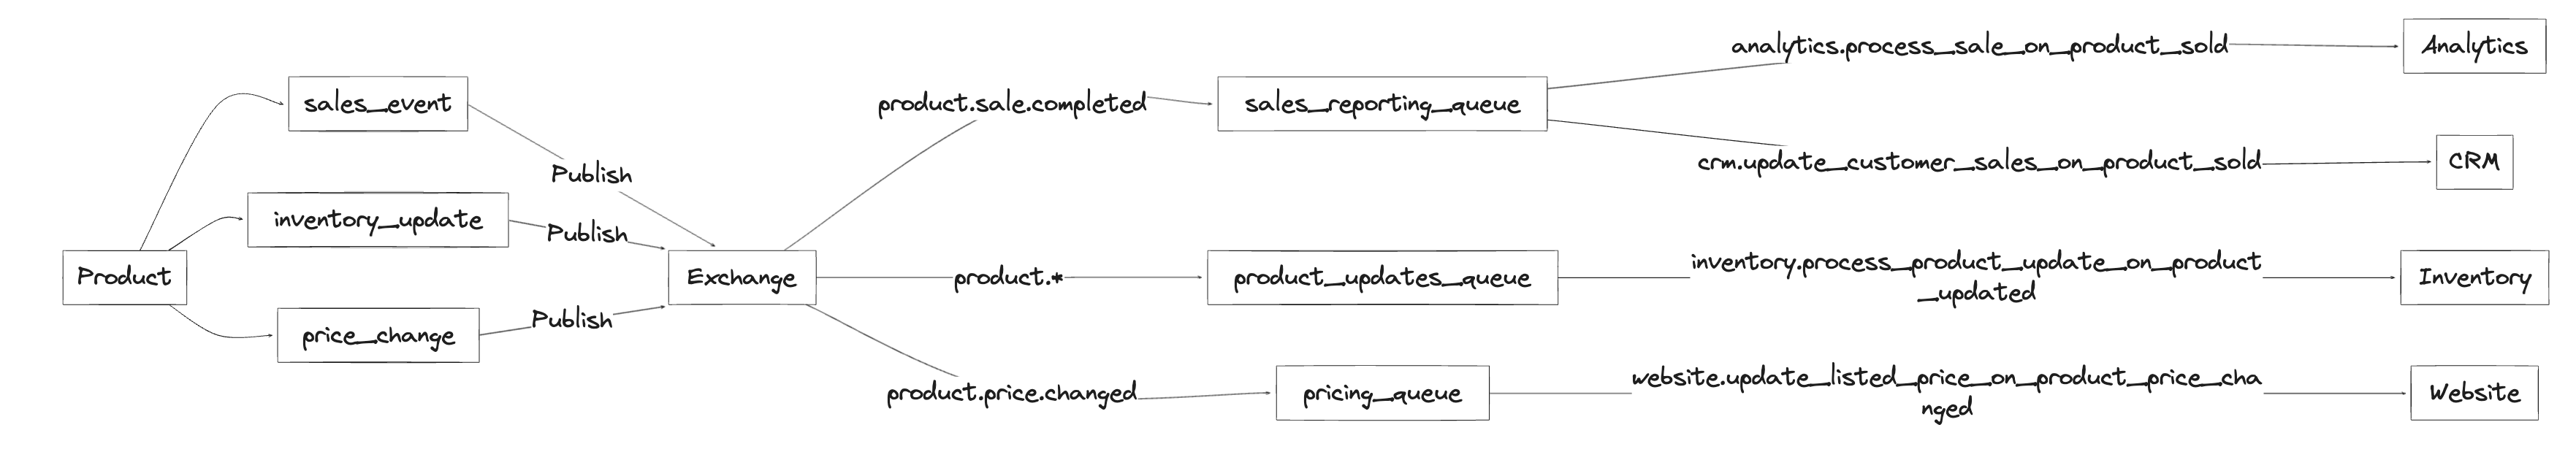
En este diagrama, podemos ver un ejemplo del flujo de mensajes en RabbitMQ. El Producer envía varios eventos (sales_event, inventory_update, price_change) al Exchange. El Exchange enruta estos mensajes a las Queues apropiadas basado en las Routing Keys y Bindings.
Luego, los mensajes son consumidos por diferentes Consumers para realizar varias tareas, como actualizar la base de datos de ventas (CRM), procesar actualizaciones de inventario (Inventory), actualizar precios en el sitio web (Website), y generar informes de ventas (Analytics).
Este ejemplo ilustra cómo RabbitMQ facilita la comunicación desacoplada entre diferentes componentes de un sistema, permitiendo un procesamiento asíncrono y escalable de eventos y tareas.
Kafka
-
En Kafka, los mensajes no van a un
Brokercentral, sino que se almacenan enTopicsen unLogdistribuido. Kafka sigue un modelo dePublish-Subscribe, donde losProducerspublican mensajes enTopics, y losConsumersse suscriben a esosTopicspara recibir los mensajes. -
Un
Topicen Kafka es una categoría o feed de nombre al que se publican los registros. LosTopicsen Kafka son siempre multiproductor y multiconsumidor; es decir, unTopicpuede tener cero, uno o muchosProducersescribiendo en él, y cero, uno o muchosConsumersleyendo de él. -
Para cada
Topic, el cluster Kafka mantiene unLogparticionado. Cada partición es una secuencia ordenada e inmutable de registros que se appende continuamente a un commit log estructurado. Cada registro en la partición se asigna con un número de identificación secuencial llamadoOffsetque identifica únicamente cada registro dentro de la partición. -
Kafka es un sistema distribuido, por lo que un
Topicgeneralmente tiene varias particiones repartidas en varios servidores del cluster Kafka. Esto permite escalabilidad más allá de la capacidad de un solo servidor. -
Los
Consumersetiquetan a sí mismos con un nombre deConsumer Groupy cada registro publicado a unTopices entregado a una instancia consumidora dentro de cadaConsumer Groupsuscrito. LosConsumer Instancespueden estar en procesos separados o en máquinas separadas. -
Si todas las instancias de
Consumertienen el mismoConsumer Group, entonces los registros se balancearán carga efectivamente sobre las instancias deConsumer. Si todas las instancias deConsumertienen diferentesConsumer Groups, entonces cada registro se transmitirá a todos los procesosConsumer.
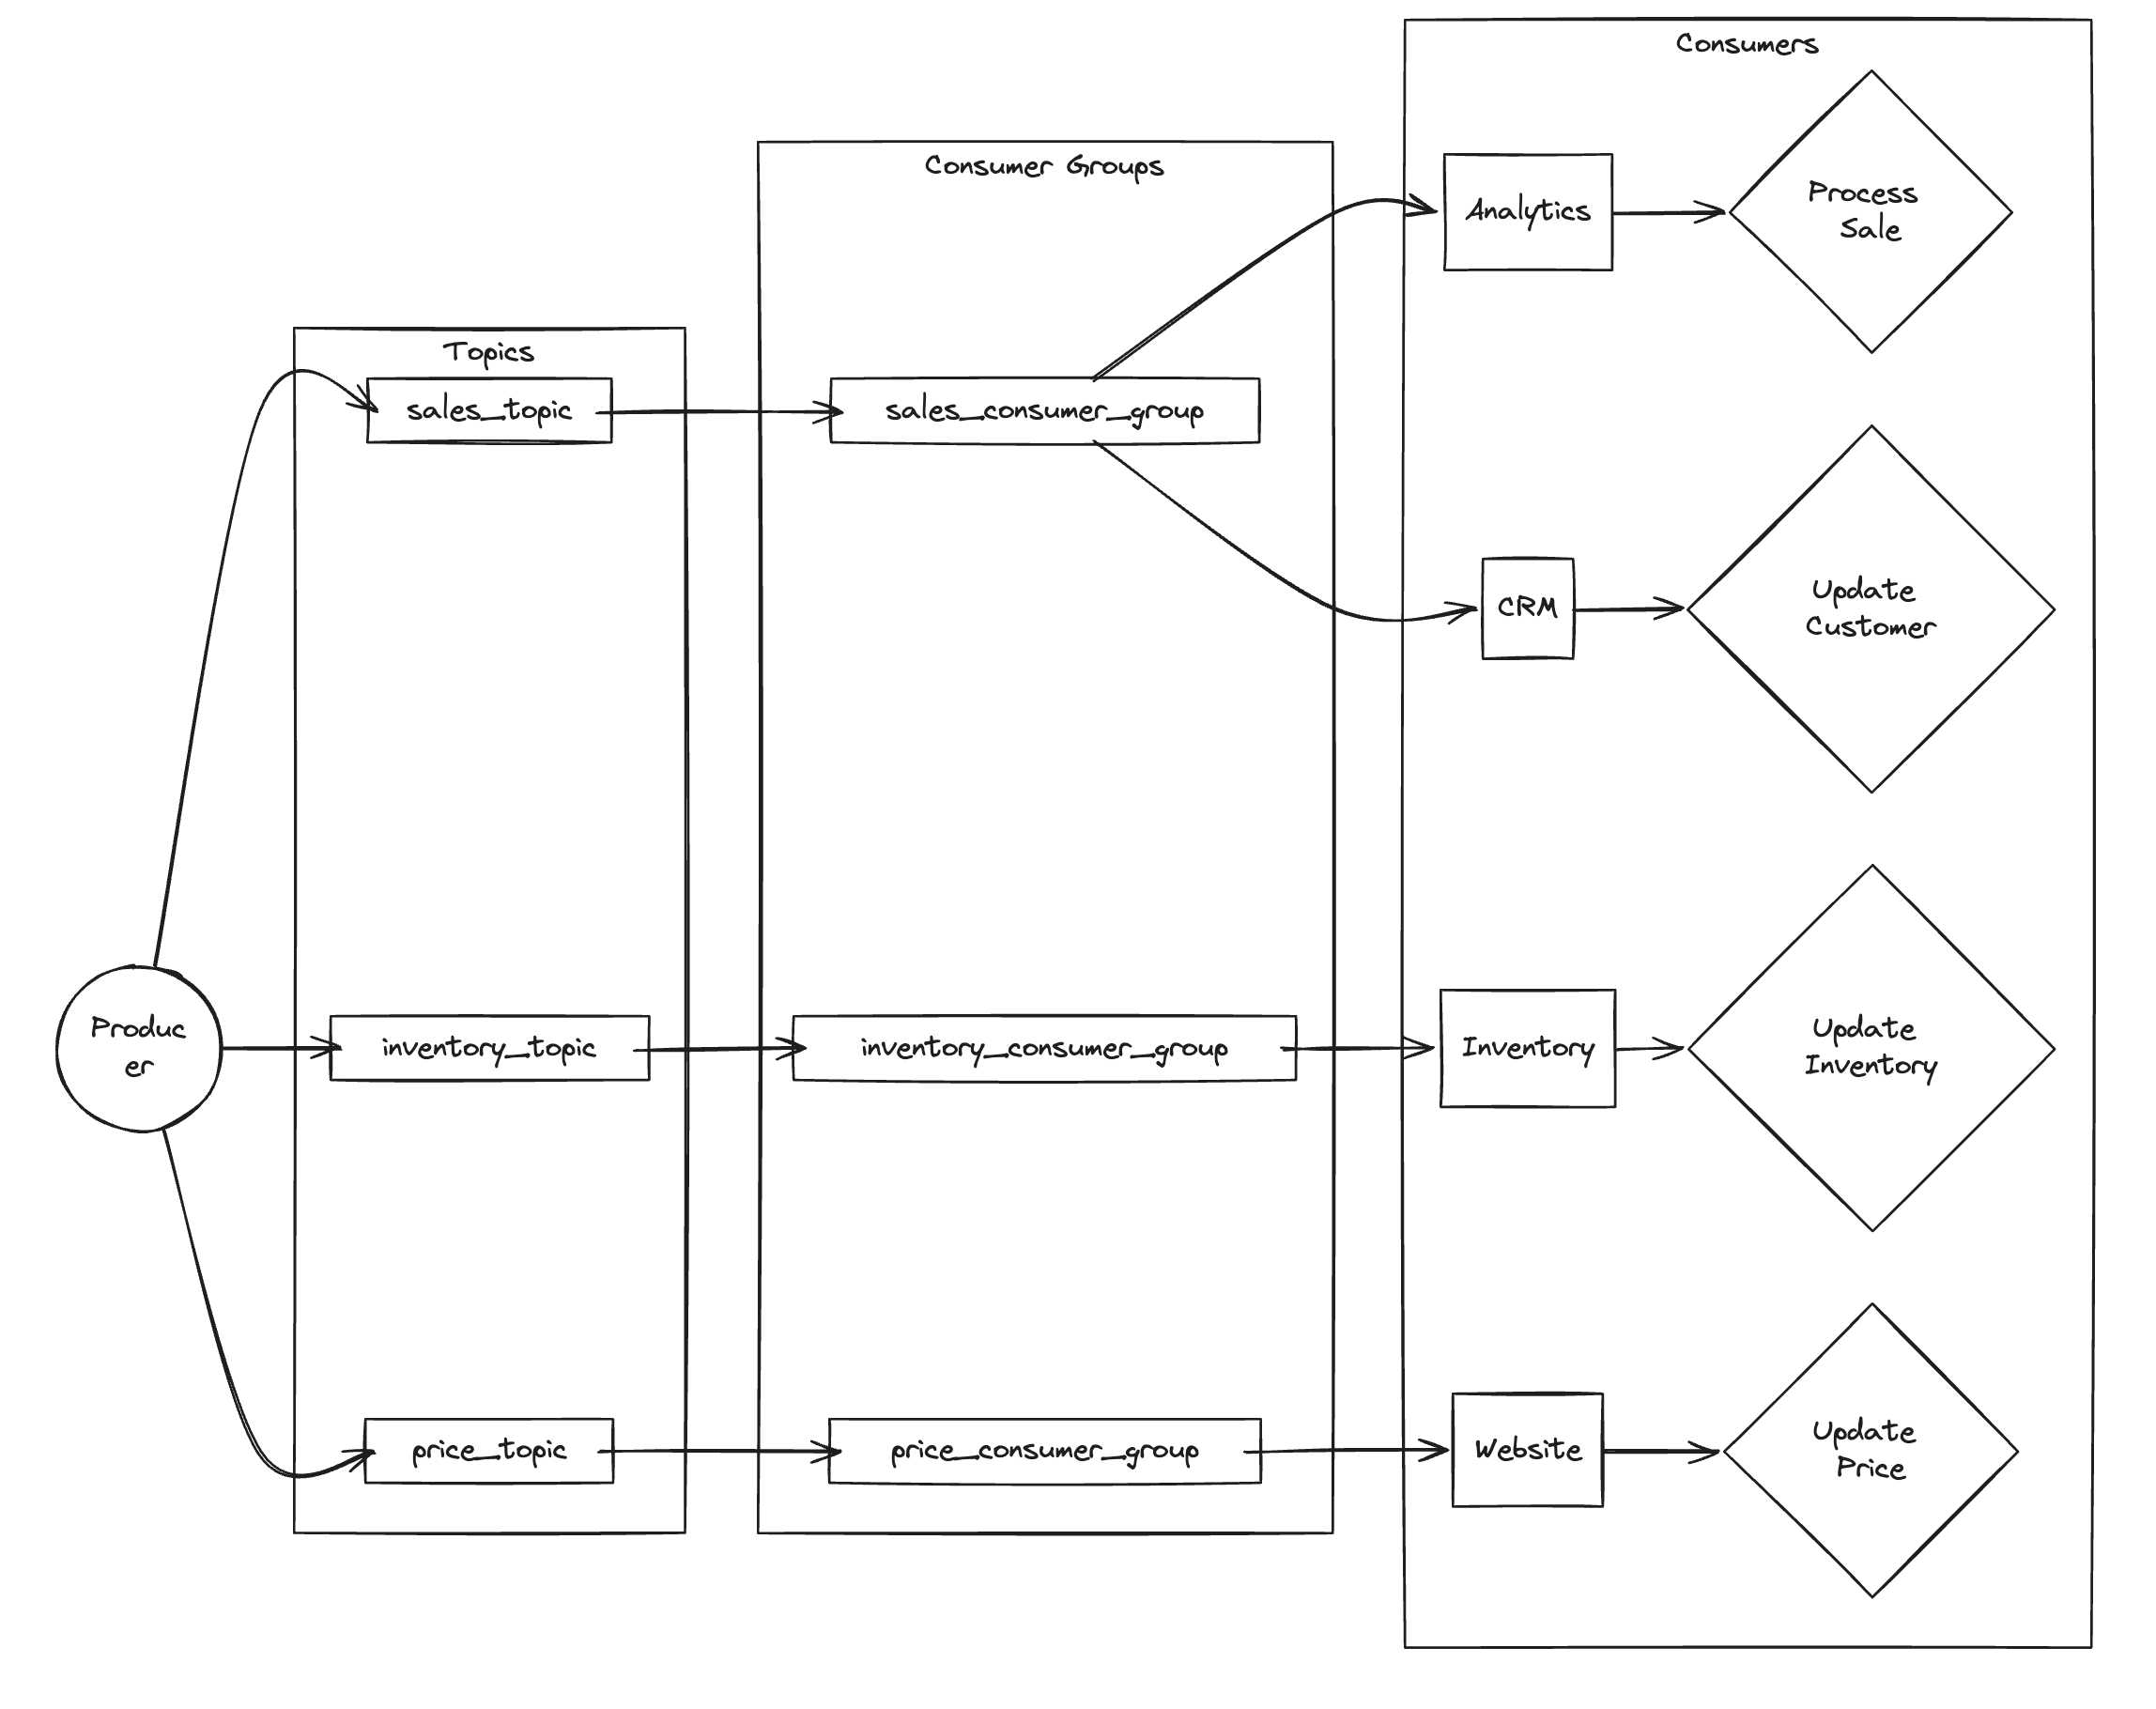
-
El
Producerpublica mensajes en tresTopics:sales_topic,inventory_topic, yprice_topic. -
Cada
Topictiene su propioConsumer Group:sales_consumer_group,inventory_consumer_group, yprice_consumer_group. LosConsumer Groupsse suscriben a losTopicspara consumir mensajes. -
Dentro de cada
Consumer Group, hayConsumersindividuales que realizan acciones específicas:Analyticsprocesa las ventas.CRMactualiza la información del cliente.Inventoryactualiza elinventario.Websiteactualiza los precios.
-
Los
TopicsenKafkasonparticionadosyreplicadosparaescalabilidadytolerancia a fallos. Cadaparticiónes unlogordenado e inmutable de mensajes. -
Los
Consumersmantienen su propiooffset(posición) en cadaparticiónque están consumiendo, permitiendo un consumo independiente a su propio ritmo.
Rendimiento y Escalabilidad: Kafka vs RabbitMQ
En cuanto al rendimiento, Kafka y RabbitMQ tienen una funcionalidad similar pero diferentes fortalezas.
Kafka
Sobresale en escenarios de transmisión de datos en tiempo real y de alto rendimiento, alardeando de una excelente escalabilidad y baja latencia. Puede manejar millones de mensajes por segundo, haciéndolo adecuado para casos de uso que requieren un procesamiento de datos rápido y continuo. Su arquitectura permite la escalabilidad horizontal distribuyendo la carga de trabajo entre múltiples brokers, manejando grandes volúmenes de datos de manera eficiente. También proporciona fuertes garantías de durabilidad al persistir los mensajes en disco, asegurando la tolerancia a fallos y la durabilidad de los datos.
RabbitMQ
Ofrece una entrega de mensajes confiable al proporcionar características como acknowledgements y persistencia de mensajes. Puede manejar miles de mensajes por segundo, haciéndolo adecuado para casos de uso con requisitos de rendimiento moderados. Su arquitectura centralizada puede introducir cierta sobrecarga de rendimiento, pero ofrece robustez e integridad de mensajes. Aunque escala verticalmente, las capacidades de escalamiento horizontal son limitadas en comparación con Kafka.
Casos de Uso Ideales para Kafka y RabbitMQ
Kafka
Ideal para una amplia variedad de diferentes casos de uso:
- Análisis en tiempo real y aplicaciones de
streaming Event sourcing, ingesta ylog aggregation, especialmente cuando se trata debig data.Data pipelinesy comunicación de microservicios con procesamiento de mensajes de alto volumen- Aplicaciones que requieren alta escalabilidad y tolerancia a fallos
RabbitMQ
Adecuado para:
Task processing, integración de servicios,workflow orchestrationy gestión de flujos de trabajo, incluidas métricas y notificaciones.- Comunicación asíncrona entre microservicios
- Sistemas de mensajería empresarial con entrega confiable de mensajes, incluida la prioridad de mensajes y necesidades de enrutamiento complejas específicas.
La flexibilidad de RabbitMQ para soportar patrones de mensajería como point-to-point, publish-subscribe y request-response lo hace útil en varios escenarios de aplicación.
Guía para tomar una decisión adecuada
En última instancia, la elección óptima depende de tus necesidades específicas:
- ¿Priorizas el alto rendimiento y el procesamiento de datos en tiempo real? Usa Kafka.
- ¿Necesitas una entrega de mensajes confiable y un enrutamiento flexible para cargas de trabajo moderadas? Usa RabbitMQ.
- ¿Consideras el
message replayy lalog aggregation? Kafka emerge como el candidato fuerte. - ¿Buscas una escalabilidad perfecta para la comunicación de microservicios con alto volumen? Kafka los soporta.
Recuerda: Ninguno es inherentemente “mejor”. Analizar tus requisitos específicos y considerar factores como la redundancia, la escalabilidad, el alto rendimiento, la alta disponibilidad, una API a gran escala y la seguridad son vitales para tomar una decisión informada.
Aspectos Adicionales a Considerar
- Complejidad: La arquitectura distribuida y el registro
append-onlyde Kafka podrían requerir más experiencia operativa en comparación con el enfoque más simple basado en colas de RabbitMQ. - Comunidad y Soporte: Ambas plataformas disfrutan de comunidades considerables y desarrollo activo.
- Integración: Evalúa las integraciones disponibles con tu infraestructura y herramientas existentes.
Eligiendo el Camino Correcto para tu Arquitectura Basada en Eventos
Con una comprensión clara de las diferencias arquitectónicas, los puntos de referencia de rendimiento y los casos de uso ideales, puedes elegir con confianza entre Kafka y RabbitMQ. Entonces, sumérgete en las necesidades específicas de tu proyecto y embárcate en el viaje hacia una arquitectura robusta y eficiente basada en eventos.